作者更新了?真的假的?
循环神经网络(Recurrent Neural Network,RNN)是深度学习发展历程中非常重要的一类神经网络。它不仅推动了自然语言处理、语音识别、时间序列预测等领域的发展,也为后来的 LSTM、GRU、Seq2Seq、Attention,乃至 Transformer 的诞生提供了重要的研究基础。
如果说 CNN(卷积神经网络)解决的核心问题是如何从具有空间结构的数据中提取特征,那么 RNN 试图解决的核心问题就是:
如何让神经网络处理具有时间顺序或前后依赖关系的数据,并利用过去的信息理解当前输入?
一、Motivation
1.1 从普通神经网络的局限开始
在学习 RNN 之前,我们通常已经接触过全连接神经网络(MLP)和卷积神经网络(CNN)。
假设我们要预测一个句子中的下一个词:
今天的天气非常____。
人类可以根据前面的语义推断,空格里很可能是“好”、“热”、“冷”。
但是,如果采用最简单的前馈神经网络,每次只输入一个词,网络就无法自动利用此前处理过的词的信息。
例如,模型在处理“非常”时,已经无法直接知道前面出现过“今天”“天气”。这些历史信息不能一起处理,就像鱼的记忆一样,看了就忘。这也体现了传统前馈网络处理序列数据时的一个核心局限:缺乏能够跨时间步持续传递的信息状态。
当然,我们也可以把整个句子一次性输入 MLP,但这会带来新问题:
- 不同句子的长度不一样,输入维度不好统一。
- 直接拼接输入不容易高效共享不同位置上的处理规则。
- 难以自然地处理逐个到达的实时数据。
- 当序列很长时,需要建模复杂的跨位置依赖关系。
于是,你作为聪明的研究者,你提出了这样的想法:能否让神经网络拥有一个不断更新的内部状态,用于保存此前处理过的信息?
想法合理,那我们便开始构建思路!
1.2 引入记忆状态
分析一下,我们人是怎么处理信息的呢?在处理上述预测句子中的下一个词的任务时,我们不由自主地提取出关键信息“今天”、”天气”等词作为重要前提。我们也希望神经网络也能有类似这样的一个步骤,以此来模仿我们人,所以我们引入了记忆状态。
普通前馈神经网络的输出可写为:
y=f(Wx+b)(1)
它的输出主要取决于当前输入 x。
而我们给设计的新神经网络引入一个隐藏状态(Hidden State),用 ht 表示:
ht=f(Wxhxt+Whhht−1+bh)(2)
这里:
- xt:当前时间步的输入。
- ht−1:上一时间步的隐藏状态。
- ht:当前更新后的隐藏状态。
- Wxh:输入到隐藏状态的权重矩阵。
- Whh:上一隐藏状态到当前隐藏状态的循环权重矩阵。
- bh:偏置。
- f:非线性激活函数,传统 RNN 常使用 tanh。
和 MLP 相比,最大的区别是增加了 ht−1。
这意味着:
当前状态=f(当前输入贡献+历史状态贡献+偏置)
1.3 RNN 的结构示意
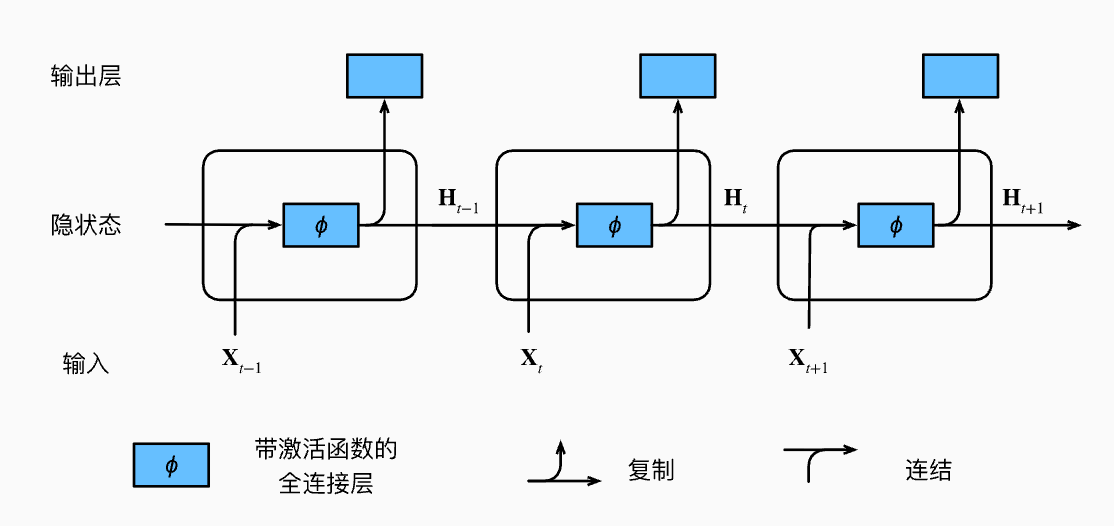
RNN 按时间展开:每一步接收当前输入,并将隐藏状态传递给下一步。图中的 yt 表示该步可计算的输出;部分任务只使用最后一步的输出。
可以把 RNN 想象成一个正在阅读文章的人:
第一步读到“今天”,形成状态 h1;第二步读到“天气”,结合 h1 更新得到 h2;第三步读到“非常”,再结合 h2 得到 h3。
因此,h3 不只依赖第三个词,还通过递归计算间接依赖前面的词。
但是在这里,我们思考一下:RNN 有传递历史信息的机制,它能够完整、准确地记住全部历史吗?
二、循环神经网络的发展历史
RNN 技术发展时间线
1982 年:Hopfield 网络
John Hopfield 提出具有循环连接的神经网络,推动了神经网络动态系统与联想记忆的研究。它不是今天常用的序列 RNN,但属于重要的早期背景。
1986—1990 年:RNN 与 BPTT 逐步成型
循环网络的训练研究不断发展。1986 年的反向传播研究及 1990 年 Werbos 对时间反向传播的系统论述,为 RNN 的训练奠定基础。Elman 在 1990 年发表的工作成为简单循环网络的经典代表。
1991 年:长期依赖问题受到系统关注
Bengio 等人在此后的研究中进一步揭示了使用梯度学习长期依赖的困难,尤其是梯度消失和梯度爆炸。
1997 年:LSTM 诞生
Hochreiter 与 Schmidhuber 提出 Long Short-Term Memory,通过专门的记忆结构缓解长距离依赖的学习困难。
2014 年:GRU、Seq2Seq 与注意力机制兴起
GRU 使用更加紧凑的门控机制。Encoder-Decoder 结构广泛应用于序列转换任务,注意力机制开始缓解固定长度上下文向量的限制。
2017 年:Transformer 发布
论文 Attention Is All You Need 提出以自注意力为核心的模型架构,在许多序列建模任务中逐步取代传统循环结构。
2023 年以来:现代状态空间模型兴起
Mamba 等架构重新探索通过状态递推与高效计算来建模长序列,为 RNN 思想提供了新的发展方向。
RNN 的发展史可以归纳为三个不断被研究的问题:
- 如何保存历史信息? —— RNN 引入隐藏状态,LSTM 和 GRU 改进记忆机制。
- 如何学习很长距离的依赖? —— 门控机制与 Attention 逐步改善信息传播。
- 如何高效处理长序列? —— Transformer、现代状态空间模型采用不同的计算与建模策略。
三、RNN 的数学原理与前向传播
又到了最头疼但是也最令人兴奋的环节!
3.1 定义输入序列
假设有一个长度为 T 的序列:
X=(x1,x2,…,xT)(3)
例如,我们利用过去 5 天的温度预测未来温度:
X=(22,23,21,25,24)
每一个 xt 代表一个时间步的数据。
实际应用中,xt 通常不只是一个数字,而是一个向量:
xt∈Rdx(4)
如果我们使用传感器测量机器人的状态,那么某一时刻的输入可能包含:
xt=vtωtθtat
分别表示线速度、角速度、姿态角和加速度。
因此,RNN 不仅能处理文字,还能处理任意具有时间顺序的特征向量序列。
3.2 隐藏状态的计算
为方便推导,我们先定义中间变量:
at=Wxhxt+Whhht−1+bh(5)
然后经过激活函数:
ht=tanh(at)(6)
这里假设:
xthtWxhWhhbh∈Rdx∈Rdh∈Rdh×dx∈Rdh×dh∈Rdh(7)
其中 dx 是输入特征维度,dh 是隐藏状态维度。
观察一下 Whh:它是一个方阵,因为它将上一时间步的隐藏状态映射到当前时间步的隐藏空间。
3.3 tanh 激活函数
传统 RNN 通常使用双曲正切函数:
tanh(x)=ex+e−xex−e−x(8)
tanh 与 sigmoid 的静态对照
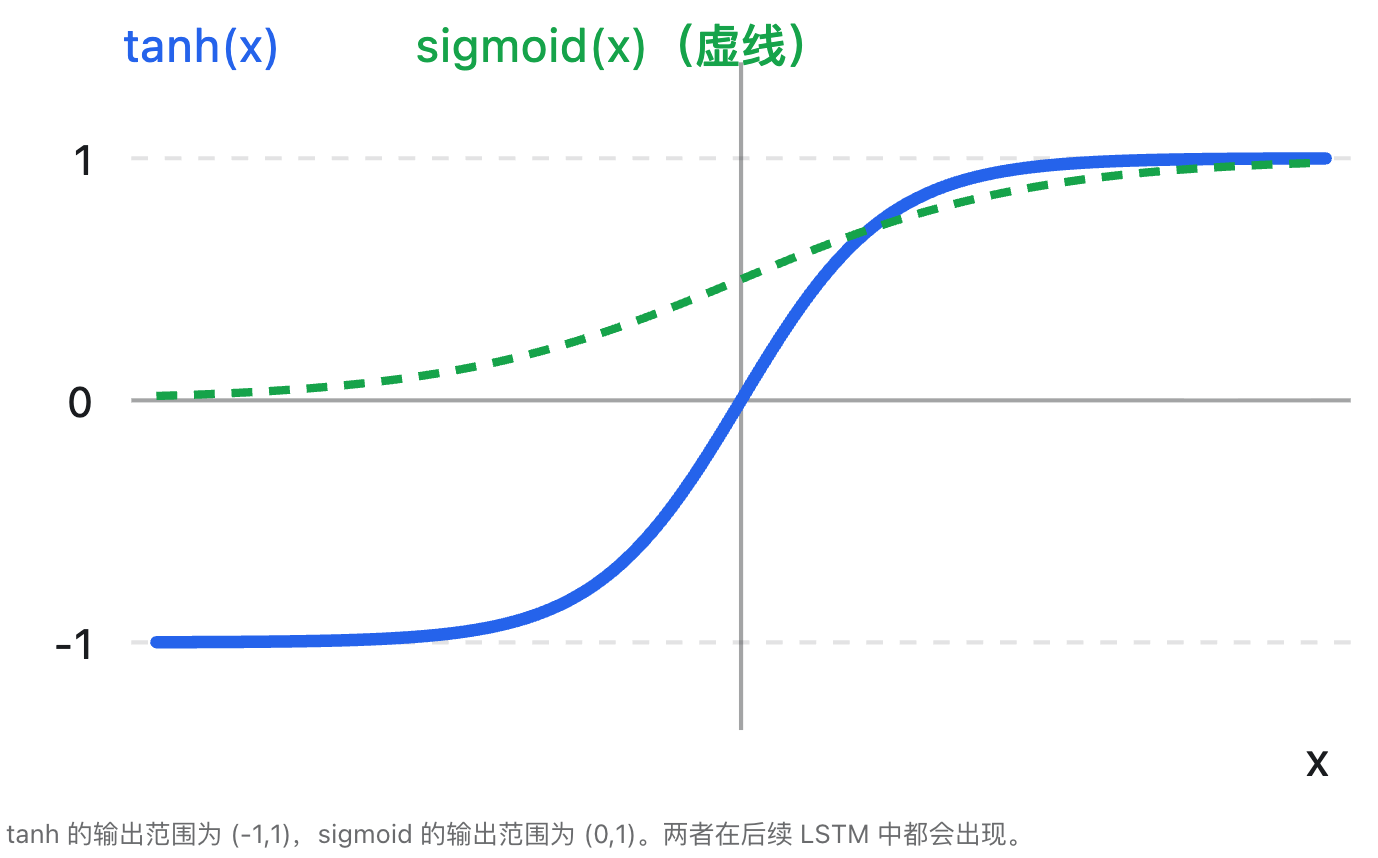
tanh 的主要特点是输出以 0 为中心,而且可以表达正、负的隐藏特征。
它的导数是:
tanh′(x)=1−tanh2(x)(9)
这个公式非常重要,因为后续分析梯度消失时会用到它。
3.4 从第一个时间步推导到第三个时间步
初始隐藏状态通常设为:
h0=0(10)
第一个时间步:
h1=tanh(Wxhx1+Whhh0+bh)(11)
第二个时间步:
h2=tanh(Wxhx2+Whhh1+bh)(12)
把式 (11) 代入式 (12),得到:
h2=tanh(Wxhx2+Whhtanh(Wxhx1+bh)+bh)(13)
第三个时间步:
h3=tanh(Wxhx3+Whhh2+bh)(14)
由此可见:
h3=F(x1,x2,x3;h0,θ)(15)
也就是说,第三个时间步的隐藏状态是之前所有输入经过递归计算后的函数。一般而言,ht 通过递推依赖于 x1,…,xt,因此能够携带历史信息;但隐藏状态是压缩后的表示,并不保证完整保存或恢复每个历史输入。
这里有一个需要特别理解的知识点:RNN 并不需要给每个时间步分别设计一组权重。
从 t=1 到 t=T,使用的是同一组参数:
Wxh,Whh,bh
这叫做时间维度上的参数共享(Parameter Sharing)。
例如,一个隐藏维度为 128 的 RNN,即使输入序列从 10 个时间步变成 100 个时间步,也不会因此产生 10 倍的模型参数。变化的是计算次数和需要处理的中间状态数量,而不是循环单元自身的参数数量。
3.5 输出是如何计算的?
隐藏状态不是最终预测结果。通常还需要一个输出层:
ot=Whyht+by(16)
如果任务是分类,可以接 softmax:
y^t,k=∑j=1Keot,jeot,k(17)
其中 K 表示类别数。
到这里,一个最基础的 RNN 单元就完整了:
htoty^t=tanh(Wxhxt+Whhht−1+bh)=Whyht+by=softmax(ot)(18)
3.6 手算一个简单 RNN
下面我们用最简单的标量 RNN,真正计算一次前向传播。计算时保留中间结果的完整精度,展示时四舍五入到小数点后四位。
设定:
ht=tanh(0.5xt+0.8ht−1)
输入序列:
x1=1,x2=2,x3=1
初始状态:
h0=0
第一步:
h1=tanh(0.5)≈0.4621
第二步:
h2=tanh(0.5×2+0.8h1)≈tanh(1.3697)≈0.8786
第三步:
h3=tanh(0.5×1+0.8h2)≈tanh(1.2029)≈0.8345
RNN 如何积累历史信息?
原交互实验的循环权重 Whh 默认值为 0.8,可调范围为 [−1.5,1.5],步长为 0.1。输入为 [1,2,1],输入权重为 0.5,初始状态为 h0=0。以下给出三组固定参数的结果:
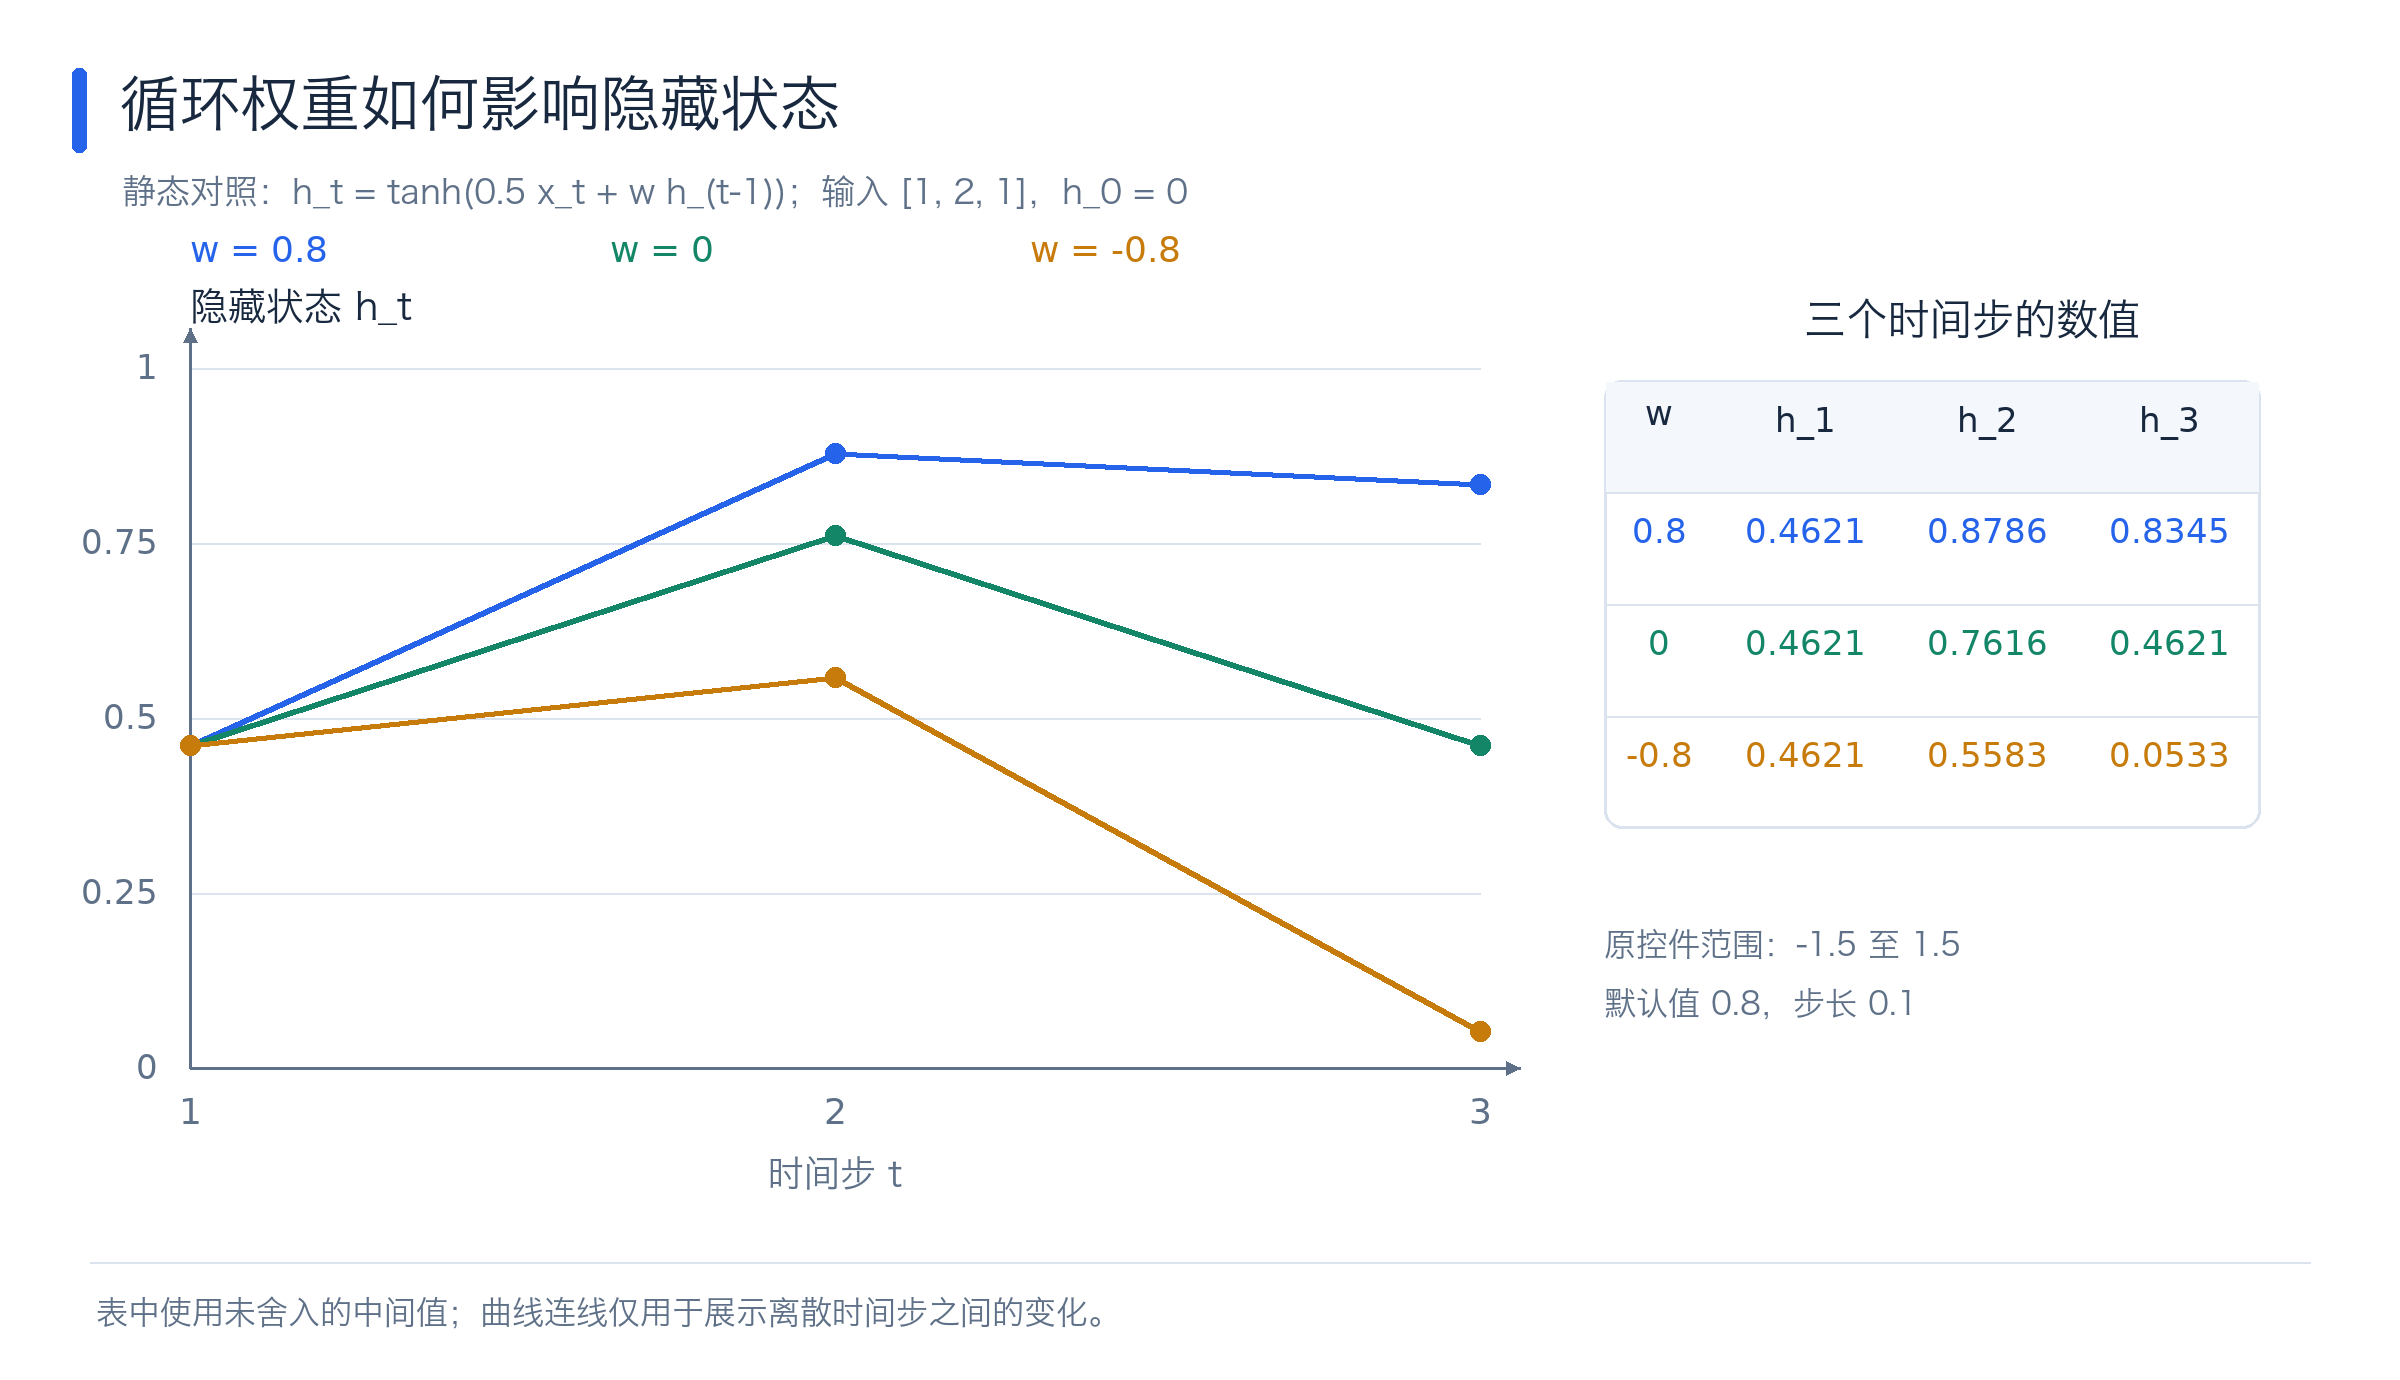
尝试把循环权重设置为 0,观察历史状态是否还会影响下一步;再尝试设置为负值,观察状态如何变化。
从这个实验可以发现,当前隐藏状态的数值不仅与 xt 有关,也会随着 Whh 的变化而发生变化。
思考题:如果 Whh=0,那么这个网络还有跨时间步传递信息的能力吗?
答案是没有,因为此时:
ht=tanh(Wxhxt+bh)
每个时间步的隐藏状态仅依赖当前输入,已经退化为逐时间步共享参数的前馈计算。
四、RNN 如何训练:时间反向传播 BPTT
骗你的这一章也很头疼。
在 MLP 中,我们使用反向传播(Backpropagation)计算梯度;而在 RNN 中,由于参数在多个时间步重复使用,我们通常采用:
Backpropagation Through Time,BPTT,时间反向传播算法。
4.1 首先定义损失函数
以每个时间步都进行分类的任务为例。
假设模型在第 t 步的预测为 y^t,真实标签为 yt。
可以定义交叉熵损失:
Lt=−k=1∑Kyt,klogy^t,k(19)
总损失:
L=t=1∑TLt(20)
如果只在最后一个时间步进行一次分类,那么损失就可以写为:
L=LT
需要注意,求和与取平均只差一个缩放系数,但会影响梯度大小和学习率选择。
4.2 为什么不能直接使用普通的单步反向传播?
我们看一条序列:
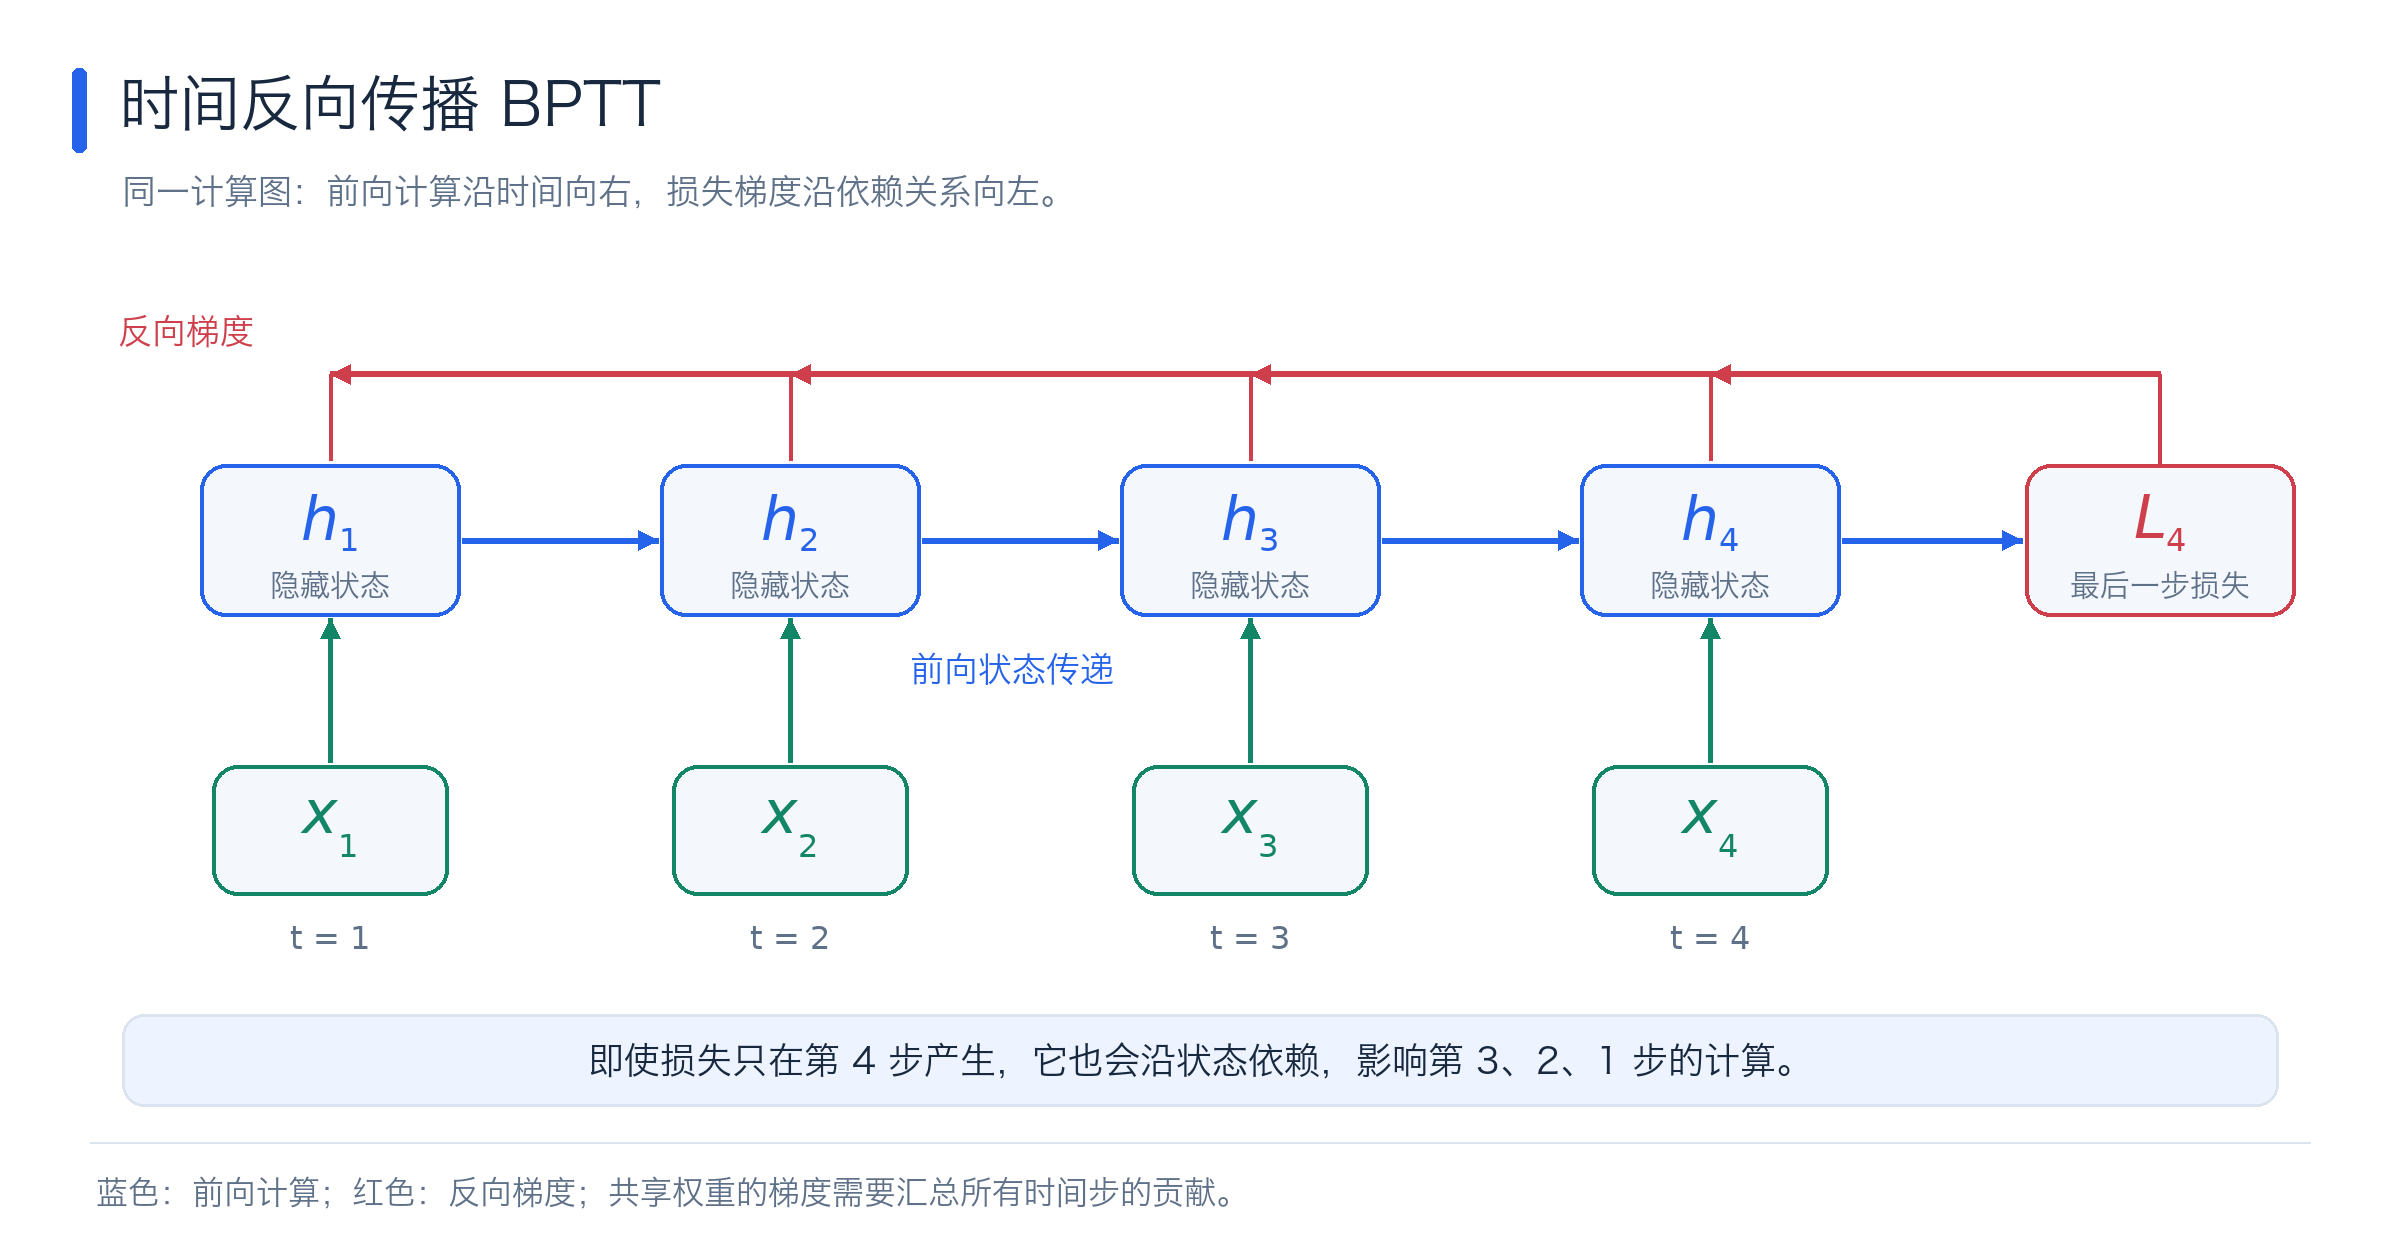
假设只有最后一步存在损失 L4。
虽然损失在第 4 步产生,但它与之前的隐藏状态存在依赖:
L4→h4→h3→h2→h1
因此,更新 Whh 时,不能只考虑第四步的直接贡献,还必须考虑它在前三个时间步对后续结果产生的间接影响。
4.3 使用链式法则推导梯度
我们先从最容易理解的情况入手:只有最后一个时间步存在损失。
与第五章保持一致,以下将隐藏状态及损失对隐藏状态的梯度均写成列向量。定义局部雅可比矩阵 Jt=∂ht−1∂ht,其维度为 dh×dh。
根据链式法则,反向传播使用雅可比矩阵的转置:
∂hT−1∂LT=(∂hT−1∂hT)T∂hT∂LT(21)
类似地:
∂hT−2∂LT=(∂hT−2∂hT−1)T(∂hT−1∂hT)T∂hT∂LT(22)
推广到任意时间步 k<T:
∂hk∂LT=Jk+1TJk+2T⋯JTT∂hT∂LT(23)
式 (23) 中的矩阵从左到右按时间索引递增排列;实际作用于最右侧梯度时,先乘 JTT,再逐步向更早的时间传播。矩阵乘法通常不可交换,不能随意颠倒顺序。
这里最关键的不是公式的长度,而是其中的连续相乘。
假设要让第 100 步的损失影响第 1 步,就需要连续经过 99 个时间步的梯度传播。
这正是梯度消失和梯度爆炸问题产生的根本原因。
4.4 推导 RNN 的局部梯度
隐藏状态更新:
ht=tanh(at)
其中:
at=Wxhxt+Whhht−1+bh
定义对角矩阵:
Dt=diag(1−ht2)(24)
根据链式法则:
∂ht−1∂ht=DtWhh(25)
它说明,隐藏状态的梯度传播由两个因素共同决定:
- 激活函数的导数 Dt
- 循环权重矩阵 Whh
在列向量梯度的约定下,反向传播对应使用雅可比矩阵的转置。
4.5 BPTT 的实际递推公式
前面只分析了最终损失。现在考虑每一步都有损失的情况。
定义:
δt=∂at∂L(26)
如果输出层为:
ot=Whyht+by
则有:
δt=(WhyT∂ot∂Lt+WhhTδt+1)⊙(1−ht2)(27)
其中 ⊙ 表示逐元素乘法,且设 δT+1=0。
这是 BPTT 中非常核心的递推关系。
它分成两个部分:
第一部分:当前时间步的直接梯度
WhyT∂ot∂Lt
当前预测产生误差,误差经过输出层传回隐藏层。
第二部分:未来时间步传回的梯度
WhhTδt+1
由于当前隐藏状态会影响未来的隐藏状态,所以未来的损失也会影响当前参数。
最后与 tanh 的导数相乘,得到当前时间步的误差项。
进而得到参数梯度:
∂Wxh∂L=t=1∑TδtxtT(28)
∂Whh∂L=t=1∑Tδtht−1T(29)
∂bh∂L=t=1∑Tδt(30)
这也解释了为什么参数共享不意味着只更新一次贡献:同一组权重在所有时间步都参与计算,因此它的最终梯度需要汇总各个时间步的贡献。
五、BPTT公式推导
这一部分是 RNN 数学原理中最核心的内容之一,也是理解 LSTM、GRU 训练机制的基础。(害不害怕)
我们从最基础的反向传播出发,逐步推导 RNN 中每个梯度的来源,最后得到完整的 BPTT 递推公式。
尤其要解决以下几个问题:
- 为什么 BPTT 要从最后一个时间步向前计算?
- 为什么当前时间步的梯度由两部分相加?
- 为什么公式中会出现矩阵转置 WhhT?
- 为什么还要乘上 1−ht2?
- 为什么参数梯度需要对所有时间步求和?
- BPTT 与普通神经网络的反向传播到底有什么不同?
读完后,你应该能够独立推导下面这个核心公式:
δt=(WhyT∂ot∂Lt+WhhTδt+1)⊙(1−ht2)(31)
5.1 首先明确:BPTT 到底要计算什么?
假设输入序列为:
X=(x1,x2,…,xT)
RNN 在时间步 t 的前向传播可以分成三步。
第一步:计算隐藏层的线性变换
at=Wxhxt+Whhht−1+bh(32)
第二步:计算隐藏状态
ht=tanh(at)(33)
第三步:计算输出
ot=Whyht+by(34)
如果是分类任务,再通过 softmax 得到预测概率:
y^t=softmax(ot)(35)
这里的 at 和 ot 都是激活前的线性输出,而 ht 是经过非线性激活得到的隐藏状态。
为了后面的求导不产生歧义,我们统一采用列向量约定,并规定梯度与对应变量具有相同的形状。
| 符号 |
含义 |
维度 |
| xt |
当前输入 |
dx×1 |
| ht |
当前隐藏状态 |
dh×1 |
| at |
隐藏层激活前变量 |
dh×1 |
| ot |
输出层 logits |
dy×1 |
| Wxh |
输入权重 |
dh×dx |
| Whh |
循环权重 |
dh×dh |
| Why |
输出权重 |
dy×dh |
假设每个时间步都有一个损失:
Lt=ℓ(ot,yt)(36)
整条序列的总损失为:
L=t=1∑TLt(37)
BPTT 的目标是计算:
∂Wxh∂L,∂Whh∂L,∂Why∂L
以及各个偏置的梯度。
然后用梯度下降更新参数。例如:
Whh←Whh−η∂Whh∂L(38)
这里 η 是学习率。
关键问题:同一个 Whh 会在每一个时间步重复使用,所以它对总损失的影响不只来自一个时间步。
这就是 BPTT 要解决的问题。
5.2 RNN 的计算图
我们用一个长度为 3 的 RNN 序列来研究。
计算图的重点是:每个时间步产生损失,隐藏状态也会影响未来时间步。下方箭头表示前向依赖关系,梯度沿这些依赖关系的反方向传播。
这个计算图中存在两种不同的依赖。
第一种是当前损失直接依赖当前隐藏状态:
ht→ot→Lt
第二种是未来损失通过后续隐藏状态间接依赖当前隐藏状态:
ht→ht+1→ht+2→⋯
比如,h2 不仅影响 L2,还会影响 h3,进而影响 L3。
因此,总损失对 h2 的梯度必须包含两个来源。
5.3 先不考虑时间递推:单个时间步怎么反向传播?
为了降低难度,我们先只分析当前时间步的损失 Lt 对隐藏状态的直接影响。
已知:
ot=Whyht+by
以及:
Lt=ℓ(ot,yt)
我们希望计算:
∂ht∂Lt
按照链式法则:(如果这步不理解的去补一下矩阵的导数,虽然后面也有,你可能看不懂)
∂ht∂Lt=(∂ht∂ot)T∂ot∂Lt(39)
因为:
∂ht∂ot=Why
所以:
∂ht∂Lt=WhyT∂ot∂Lt(40)
为什么是矩阵转置?
这涉及向量求导时的方向。
假设:
o=Wh
其中:
W=[w11w21w12w22]
那么:
o1o2=w11h1+w12h2=w21h1+w22h2
我们想知道总损失对 h1 的影响。
因为 h1 同时影响 o1 和 o2,所以:
∂h1∂L=∂o1∂Lw11+∂o2∂Lw21(41)
同理:
∂h2∂L=∂o1∂Lw12+∂o2∂Lw22(42)
写成矩阵:
[∂h1∂L∂h2∂L]=WT[w11w12w21w22][∂o1∂L∂o2∂L]
于是:
∇hL=WT∇oL(43)
你可以这样理解:
- 前向传播使用 W,把隐藏状态映射到输出。
- 反向传播使用 WT,把输出层的梯度传回隐藏层。
如果使用 Softmax + 交叉熵
假设:
y^t,k=∑jeot,jeot,k
真实标签 yt 是 one-hot 向量,交叉熵为:
Lt=−k∑yt,klogy^t,k
则有一个非常方便的求导结果:
∂ot∂Lt=y^t−yt(44)
这个公式成立于标准 softmax 配合交叉熵、目标分布归一化且对类别求和的情形。如果损失进行了额外缩放,梯度也需要相应缩放。
因此,当前时间步的直接梯度就变成:
∂ht∂Lt=WhyT(y^t−yt)(45)
这就是当前输出误差传回隐藏状态的过程。
5.4 核心推导
现在开始真正推导 BPTT。
我们暂时不使用复杂的矩阵,而是先从 3 个时间步的 RNN 出发。
假设总损失为:
L=L1+L2+L3(46)
并且每个时间步都有:
ht=tanh(at)
at=Wxhxt+Whhht−1+bh
由于第三个时间步已经是最后一步,不存在未来的损失。
因此:
∂h3∂L=∂h3∂L3(47)
代入之前的结果:
∂h3∂L=WhyT∂o3∂L3(48)
接下来还需要把梯度从 h3 传递到 a3。
因为:
h3=tanh(a3)
而 tanh 的导数为:
tanh′(a3)=1−tanh2(a3)=1−h32
所以:
∂a3∂L=∂h3∂L⊙(1−h32)(49)
现在定义 BPTT 中最重要的误差变量:
δt≡∂at∂L(50)
于是:
δ3=(WhyT∂o3∂L3)⊙(1−h32)(51)
现在我们想计算:
∂h2∂L
首先问自己:h2 会影响哪些损失?
它直接影响:
h2→o2→L2
它也会通过 a3、h3 影响:
h2→a3→h3→o3→L3
但是,h2 不会影响过去已经计算的 L1。
因此:
∂h2∂L=∂h2∂L2+∂h2∂L3(52)
我们来分别计算。
第一项:来自当前时间步的直接损失
由式 (40):
∂h2∂L2=WhyT∂o2∂L2(53)
第二项:来自未来时间步的间接损失
观察第三个时间步:
a3=Wxhx3+Whhh2+bh
因为 L3 通过 a3 依赖 h2,所以:
∂h2∂L3=(∂h2∂a3)T∂a3∂L3(54)
分别看两部分。
首先:
∂h2∂a3=Whh
其次,由于第三步是最后一步:
∂a3∂L3=δ3
因此:
∂h2∂L3=WhhTδ3(55)
现在把式 (53) 和式 (55) 相加:
∂h2∂L=WhyT∂o2∂L2+WhhTδ3(56)
这就是 BPTT 中“两个梯度来源相加”的本质。
观察 h₂ 的两条梯度回传路径
箭头表示前向依赖关系;反向传播沿箭头反方向回传。由于总损失依赖多条计算路径,梯度在汇合点相加。
现在距离 δ2 只差一步。
因为:
h2=tanh(a2)
所以:
δ2=∂h2∂L⊙(1−h22)
代入式 (56):
δ2=(WhyT∂o2∂L2+WhhTδ3)⊙(1−h22)(57)
这正是我们要推导的公式在第二个时间步的形式。
第一个时间步:重复同样的过程
现在计算:
∂h1∂L
因为 h1 影响 L1、L2、L3,所以:
∂h1∂L=∂h1∂L1+∂h1∂(L2+L3)(58)
第一项依然是:
∂h1∂L1=WhyT∂o1∂L1(59)
第二项呢?
注意:
h1→a2→h2
而 δ2 已经包含了 L2 和 L3 对 a2 的全部梯度。
因此:
∂h1∂(L2+L3)=WhhTδ2(60)
这里特别重要:
虽然 δ2 只写了一个下标 2,但它已经汇总了从第二步到最后一步的所有后续损失贡献。
于是:
∂h1∂L=WhyT∂o1∂L1+WhhTδ2
再乘上 tanh 的导数:
δ1=(WhyT∂o1∂L1+WhhTδ2)⊙(1−h12)(61)
将三个时间步合并
我们目前推导得到:
δ3δ2δ1=(WhyT∂o3∂L3)⊙(1−h32)=(WhyT∂o2∂L2+WhhTδ3)⊙(1−h22)=(WhyT∂o1∂L1+WhhTδ2)⊙(1−h12)(62)
观察规律:每个时间步都有完全相同的结构。
因此推广到长度为 T 的序列:
δt=(WhyT∂ot∂Lt+WhhTδt+1)⊙(1−ht2)(63)
其中边界条件:
δT+1=0(64)
这样最后一个时间步就可以直接使用相同的公式。
5.5 用更规范的计算图方法理解递推公式
前面的推导是从三个具体时间步展开的。现在我们换一种更适合以后研究 LSTM、GRU 和自动微分的写法。
定义:
gt=∂ht∂L(65)
注意区分两个变量:
gtδt=∂ht∂L=∂at∂L(66)
因为 ht=tanh(at),有:
δt=Dtgt(67)
其中:
Dt=diag(1−ht2)
现在我们先求 gt。
计算图中,ht 有两个直接影响方向:
ht→ot
以及:
ht→at+1
因此,在不考虑其他额外连接的标准 RNN 中:
gt=(∂ht∂ot)T∂ot∂L+(∂ht∂at+1)T∂at+1∂L(68)
因为当前输出 ot 只直接影响 Lt,所以:
∂ot∂L=∂ot∂Lt
再代入:
∂ht∂ot=Why
∂ht∂at+1=Whh
以及:
∂at+1∂L=δt+1
得到:
gt=WhyT∂ot∂Lt+WhhTδt+1(69)
再由式 (67):
δt=Dtgt
即可得到式 (63)。
为什么先相加,再乘 tanh 导数?
这是一个特别容易产生错误的地方。
公式结构是:
δt=gt(当前输出梯度+未来传回梯度)⊙tanh 导数(1−ht2)
而不是只让某一个梯度乘上 tanh 的导数。
原因是:两条路径都经过同一个隐藏状态 ht=tanh(at)。
两条路径先在 ht 汇总,然后整体通过激活函数反向传递到 at。
换句话说:
各下游路径梯度汇总⟶经过当前激活函数求导
这就是反向传播在计算图分叉、汇合时的通用规则。
对角矩阵形式
我们还可以将递推公式写为:
δt=Dt(WhyT∂ot∂Lt+WhhTδt+1)(70)
请注意矩阵乘法的顺序。
这里是:
DtWhhTδt+1
而不是:
WhhTDtδt+1
因为矩阵乘法通常不可交换:
AB=BA
你在前面学习的局部雅可比矩阵是:
∂ht−1∂ht=DtWhh(71)
它的转置为:
(∂ht−1∂ht)T=WhhTDt(72)
于是从 gt 向 gt−1 传播梯度时,确实是:
WhhTDtgt
由于:
Dtgt=δt
所以:
gt−1=WhyT∂ot−1∂Lt−1+WhhTδt(73)
两种写法完全一致,只是选取的中间变量不同。
六、真正手算一遍 BPTT:从第三步反传到第一步
到这里,我们已经完成理论推导。但只看公式仍然容易觉得抽象。
现在我们做一个可以拿纸笔逐步计算的完整例子。
为了降低矩阵计算的复杂度,先让隐藏状态、输入和输出全部为标量。
这不是改变 BPTT 的原理,而是让所有矩阵运算都退化为普通数字运算。
6.1 设置一个最简单的 RNN
令:
at=wxt+uht−1(74)
ht=tanh(at)(75)
ot=vht(76)
设定参数:
w=0.5,u=0.5,v=1
输入:
x1=1,x2=1,x3=1
初始隐藏状态:
h0=0
目标输出全部设为 0:
y1=y2=y3=0
使用平方误差的一半作为单步损失:
Lt=21(ot−yt)2(77)
于是:
∂ot∂Lt=ot−yt(78)
6.2 前向传播
计算时保留中间结果的完整精度,以下展示值四舍五入到小数点后四位;含有舍入值的代入式使用近似等号。
第一步:
a1=0.5×1+0.5×0=0.5
h1=tanh(0.5)≈0.4621
第二步:
a2=0.5+0.5h1≈0.7311
h2=tanh(a2)≈0.6237
第三步:
a3=0.5+0.5h2≈0.8119
h3=tanh(a3)≈0.6706
因为 v=1,所以 ot=ht。
总损失约为:
L=21(h12+h22+h32)≈0.5261
下面正式开始反向传播。
6.3 第一步:求 δ3
我们知道:
δ3=(v∂o3∂L3)(1−h32)
因为:
∂o3∂L3=o3=h3≈0.6706
所以:
δ3≈0.6706(1−0.67062)≈0.3690(79)
6.4 第二步:求 δ2
根据 BPTT:
δ2=(vo2+uδ3)(1−h22)
把数字代入:
δ2≈(0.6237+0.5×0.3690)(1−0.62372)≈0.4938(80)
这里可以明显看到两个梯度来源:
第二步的直接误差0.6237+第三步传回的误差0.1845
如果只计算当前时间步的误差,就会漏掉后面这个 0.1845 左右的贡献。
这正是普通单步反向传播与完整 BPTT 的核心区别。
6.5 第三步:求 δ1
同样:
δ1=(vo1+uδ2)(1−h12)
代入:
δ1≈(0.4621+0.5×0.4938)(1−0.46212)≈0.5576(81)
至此,得到三个误差项:
δ1δ2δ3≈0.5576≈0.4938≈0.3690(82)
它们分别描述了总损失对三个时间步激活前变量的敏感程度。
6.6 BPTT 的完整算法流程
现在我们把所有数学推导整合起来。
定义:
et=∂ot∂Lt
δt=∂at∂L
6.6.1 前向传播阶段
按照时间顺序,从 t=1 到 t=T:
athtotLt=Wxhxt+Whhht−1+bh=tanh(at)=Whyht+by=ℓ(ot,yt)(83)
保存各时间步的隐藏状态和其他反向传播所需的中间变量。
6.6.2 反向传播阶段
从 t=T 到 t=1:
先计算当前输出误差:
et=∂ot∂Lt(84)
再计算隐藏层误差:
δt=(WhyTet+WhhTδt+1)⊙(1−ht2)(85)
其中:
δT+1=0
然后累积参数梯度:
∇WxhL∇WhhL∇WhyL∇bhL∇byL=t∑δtxtT=t∑δtht−1T=t∑ethtT=t∑δt=t∑et(86)
最后使用优化器更新参数。
七、BPTT 和梯度消失到底是什么关系?
现在我们可以用已经推导的递推公式,进一步解释为什么 RNN 会出现梯度消失。
先考虑只有最后一个时间步存在损失的情况。
此时对 t<T,当前直接损失为零:
et=0
那么:
δt=DtWhhTδt+1(87)
逐步展开:
δT−1=DT−1WhhTδT
δT−2=DT−2WhhTDT−1WhhTδT
推广:
δk=(DkWhhTDk+1WhhT⋯DT−1WhhT)δT(88)
其中所有矩阵按实际传播顺序相乘。
这里包含两个可能让梯度发生缩小或放大的因素:
一是 Dt,即 tanh 激活函数的导数;二是 WhhT,即循环权重矩阵。
对于 tanh:
tanh′(a)=1−tanh2(a)
当隐藏状态(tanh 的输出)ht=tanh(at) 接近 1 或 −1,即输入 at 进入饱和区时:
tanh′(at)=1−ht2≈0
于是部分梯度分量会被明显缩小。
而连续经过很多时间步,就可能发生梯度消失。
不过,真实的矩阵连乘行为还取决于各矩阵的方向和奇异值等因素,并不是只要每个 tanh 导数小于 1,就一定发生严重的梯度消失。
这也解释了为什么 LSTM 和 GRU 要构建门控及加法状态更新路径:它们试图让有用的历史信息与梯度能够更有效地沿时间传播。
7.1 梯度消失
我们把第 4.3 节式 (23) 中的矩阵乘积简化为一个标量模型。
这里的 n 表示向过去反传的步数,gn 是简化模型中的标量梯度,g0 是反传起点的梯度;它们不再表示第 5.5 节按前向时间索引定义的梯度向量。假设每一步梯度传播都需要乘上一个常数 α,经过 n 步后:
gn=αng0(89)
如果:
∣α∣<1
那么:
n→∞limαn=0
例如:
0.510≈0.000977
0.520≈9.54×10⁻⁷
如果一个时间步对更早时间步的梯度缩小一半,那么传播 20 步之后,就只剩下原来的约百万分之一。
静态实验:梯度经过多次传播会怎样?
原交互实验的每步梯度倍率 ∣α∣ 默认值为 0.8,可调范围为 [0.2,1.5],步长为 0.05。以下将初始梯度大小设为 1,展示倍率连续相乘后的梯度大小:
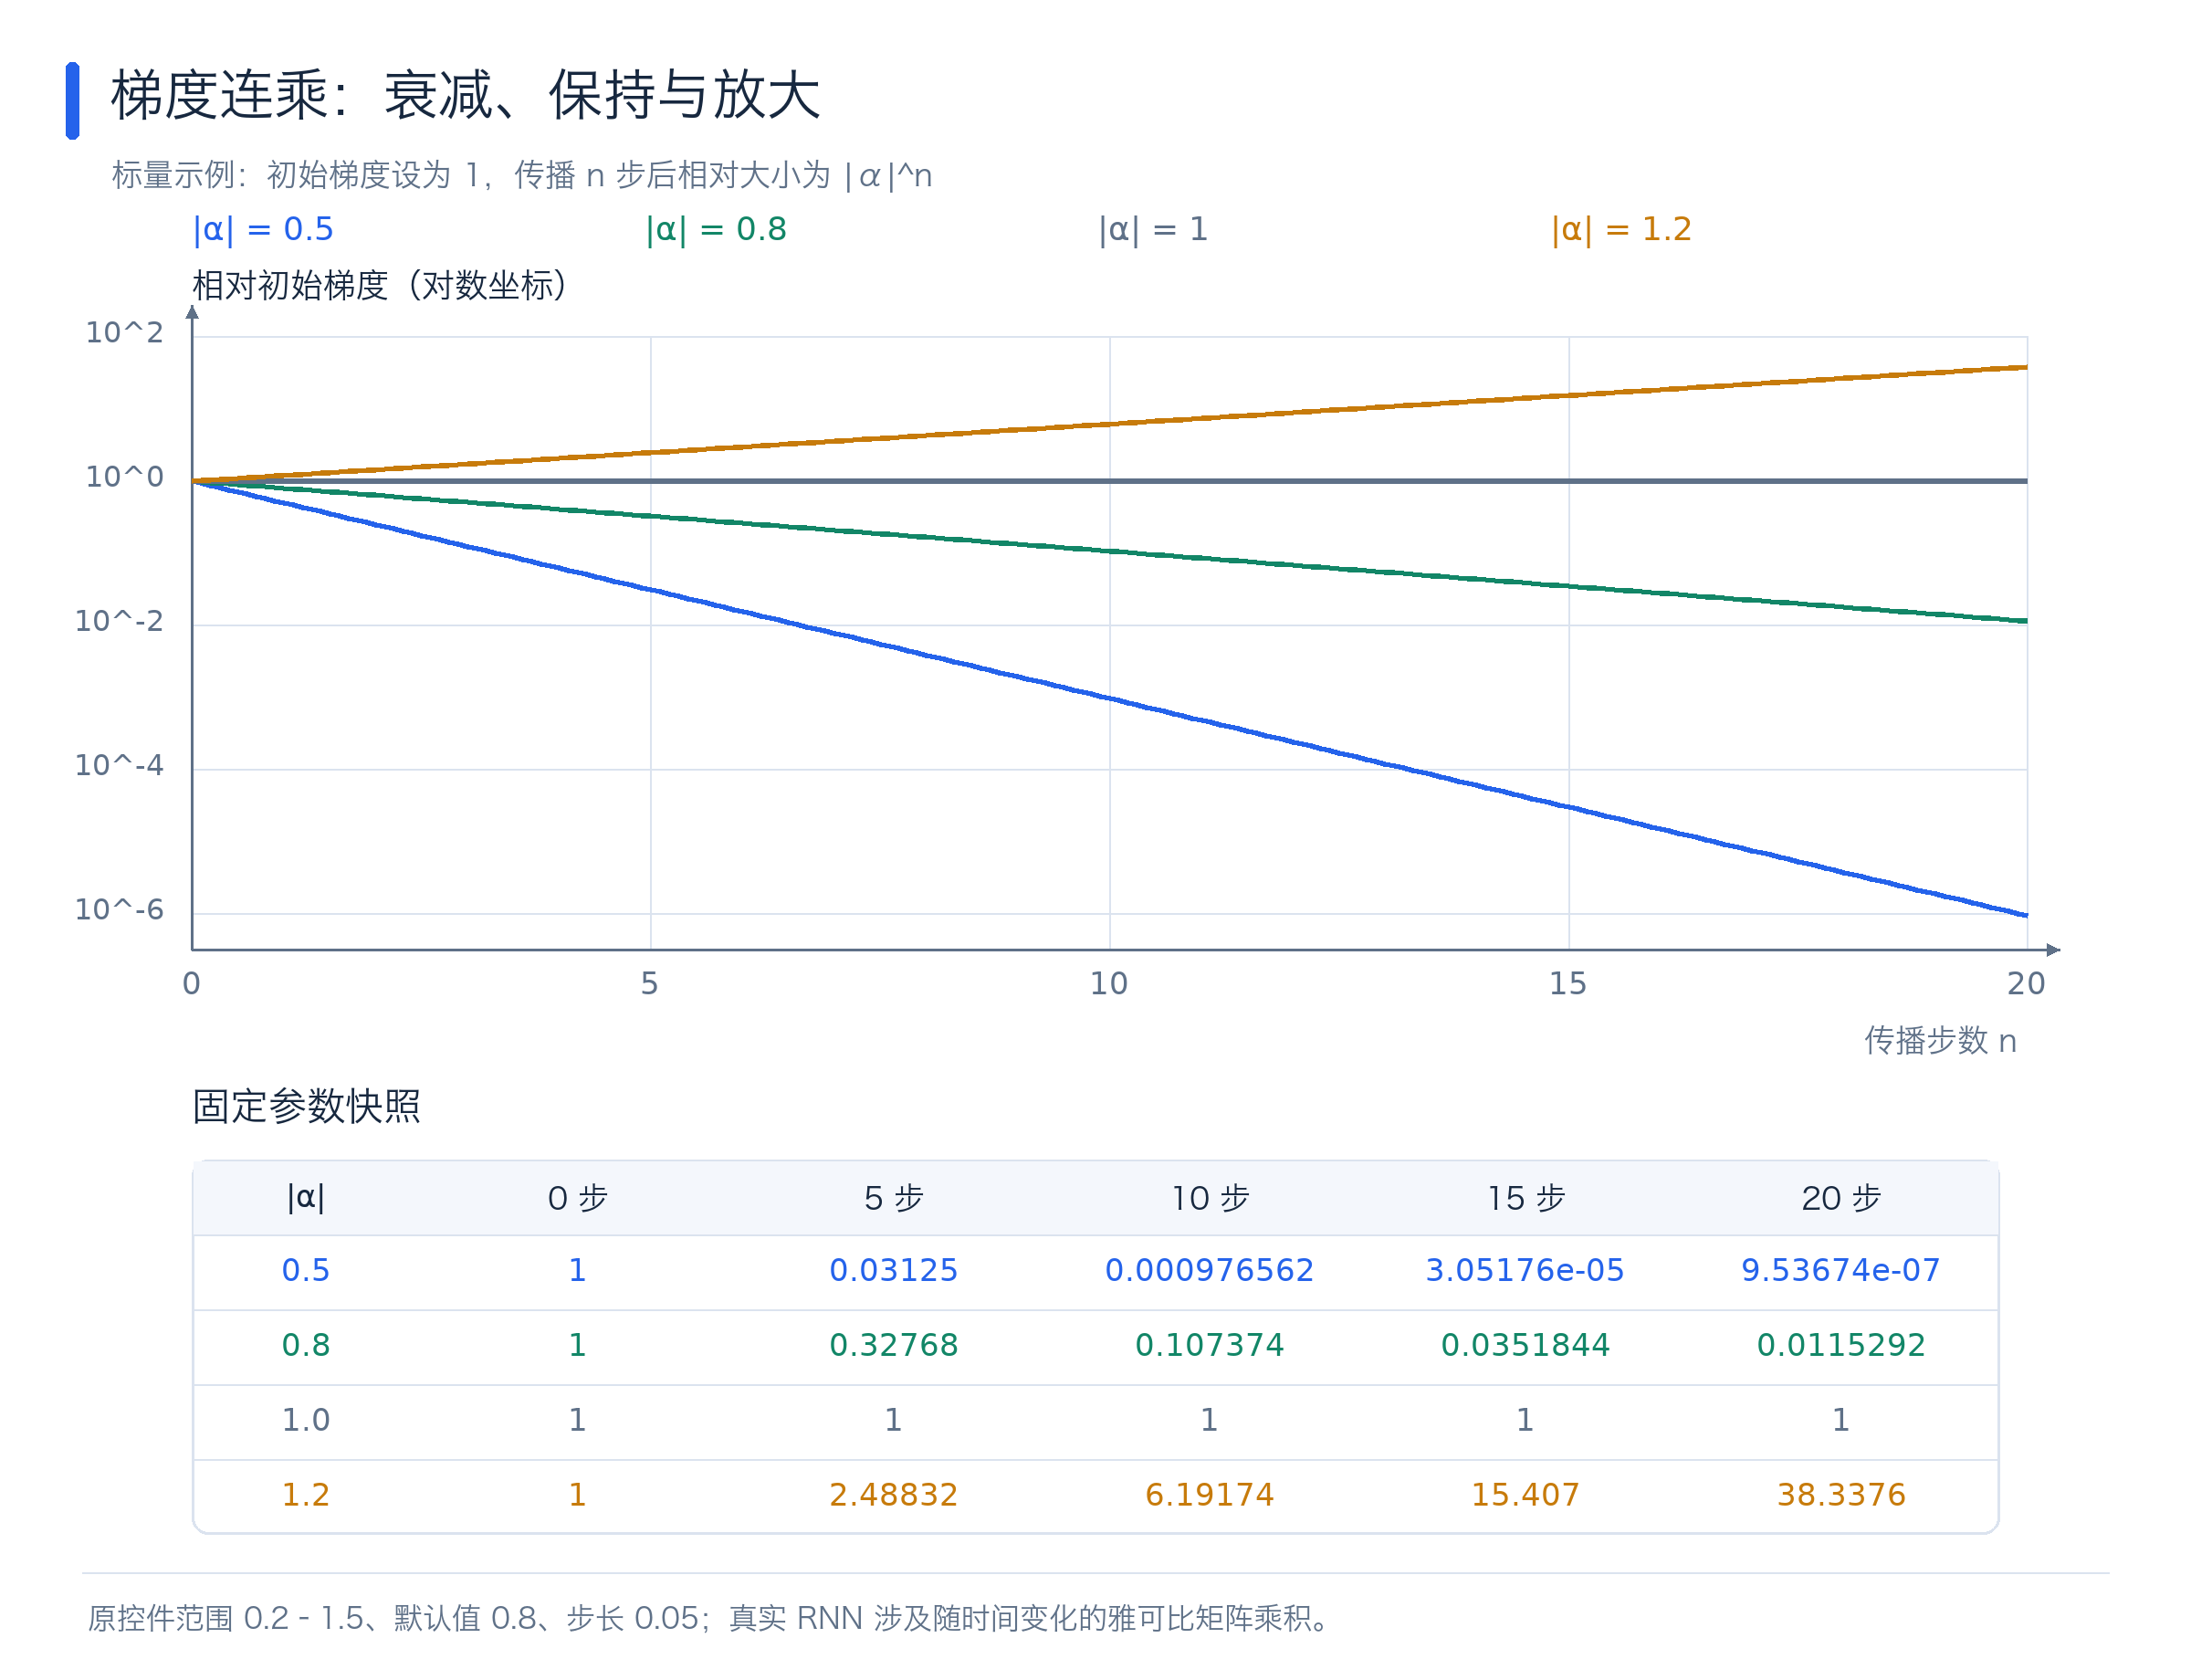
当历史信息需要通过很多步才能影响最终预测时,早期时间步收到的训练信号可能变得非常微弱,模型很难学会长期依赖。
例如:
我昨天在公园看到了一只小猫,后来又去商店、学校、图书馆……最后它突然跑了。
模型需要理解“它”指代前面出现的“小猫”。
如果隐藏状态中的相关信息在多次更新中逐渐丢失,模型就难以正确建立这种联系。
7.2 梯度爆炸
另一个极端是:
∣α∣>1
此时:
n→∞lim∣α∣n=∞
例如:
1.520≈3325.26
这意味着非常小的梯度可能经过多次传播后迅速放大。
在训练中,可能会表现为损失剧烈震荡、参数更新过大,甚至产生 NaN。
7.3 如何解决?
| 方法 |
核心思想 |
主要作用 |
| 梯度裁剪 |
限制梯度范数 |
缓解梯度爆炸 |
| 合理初始化 |
控制循环权重的数值特性 |
改善训练稳定性 |
| LSTM |
引入独立记忆单元和门控 |
缓解长期依赖学习困难 |
| GRU |
使用更新门与重置门 |
缓解长期依赖学习困难 |
| TBPTT |
仅反传有限长度的序列 |
降低计算和内存开销 |
| Attention |
直接访问相关位置的信息 |
缩短部分信息传递路径 |
这里要特别区分:
梯度裁剪主要针对梯度爆炸,并不能直接解决梯度消失。
截断 BPTT 虽然能够减少训练开销,但它也会限制当前训练更新中梯度能够直接传播的时间范围。
八、RNN 的几种常见网络架构
前面讨论的是单个循环单元,但实际应用中还要考虑:一个网络究竟接收什么样的序列,以及应该输出什么样的结果?
8.1 按输入与输出形式分类
四类典型序列架构
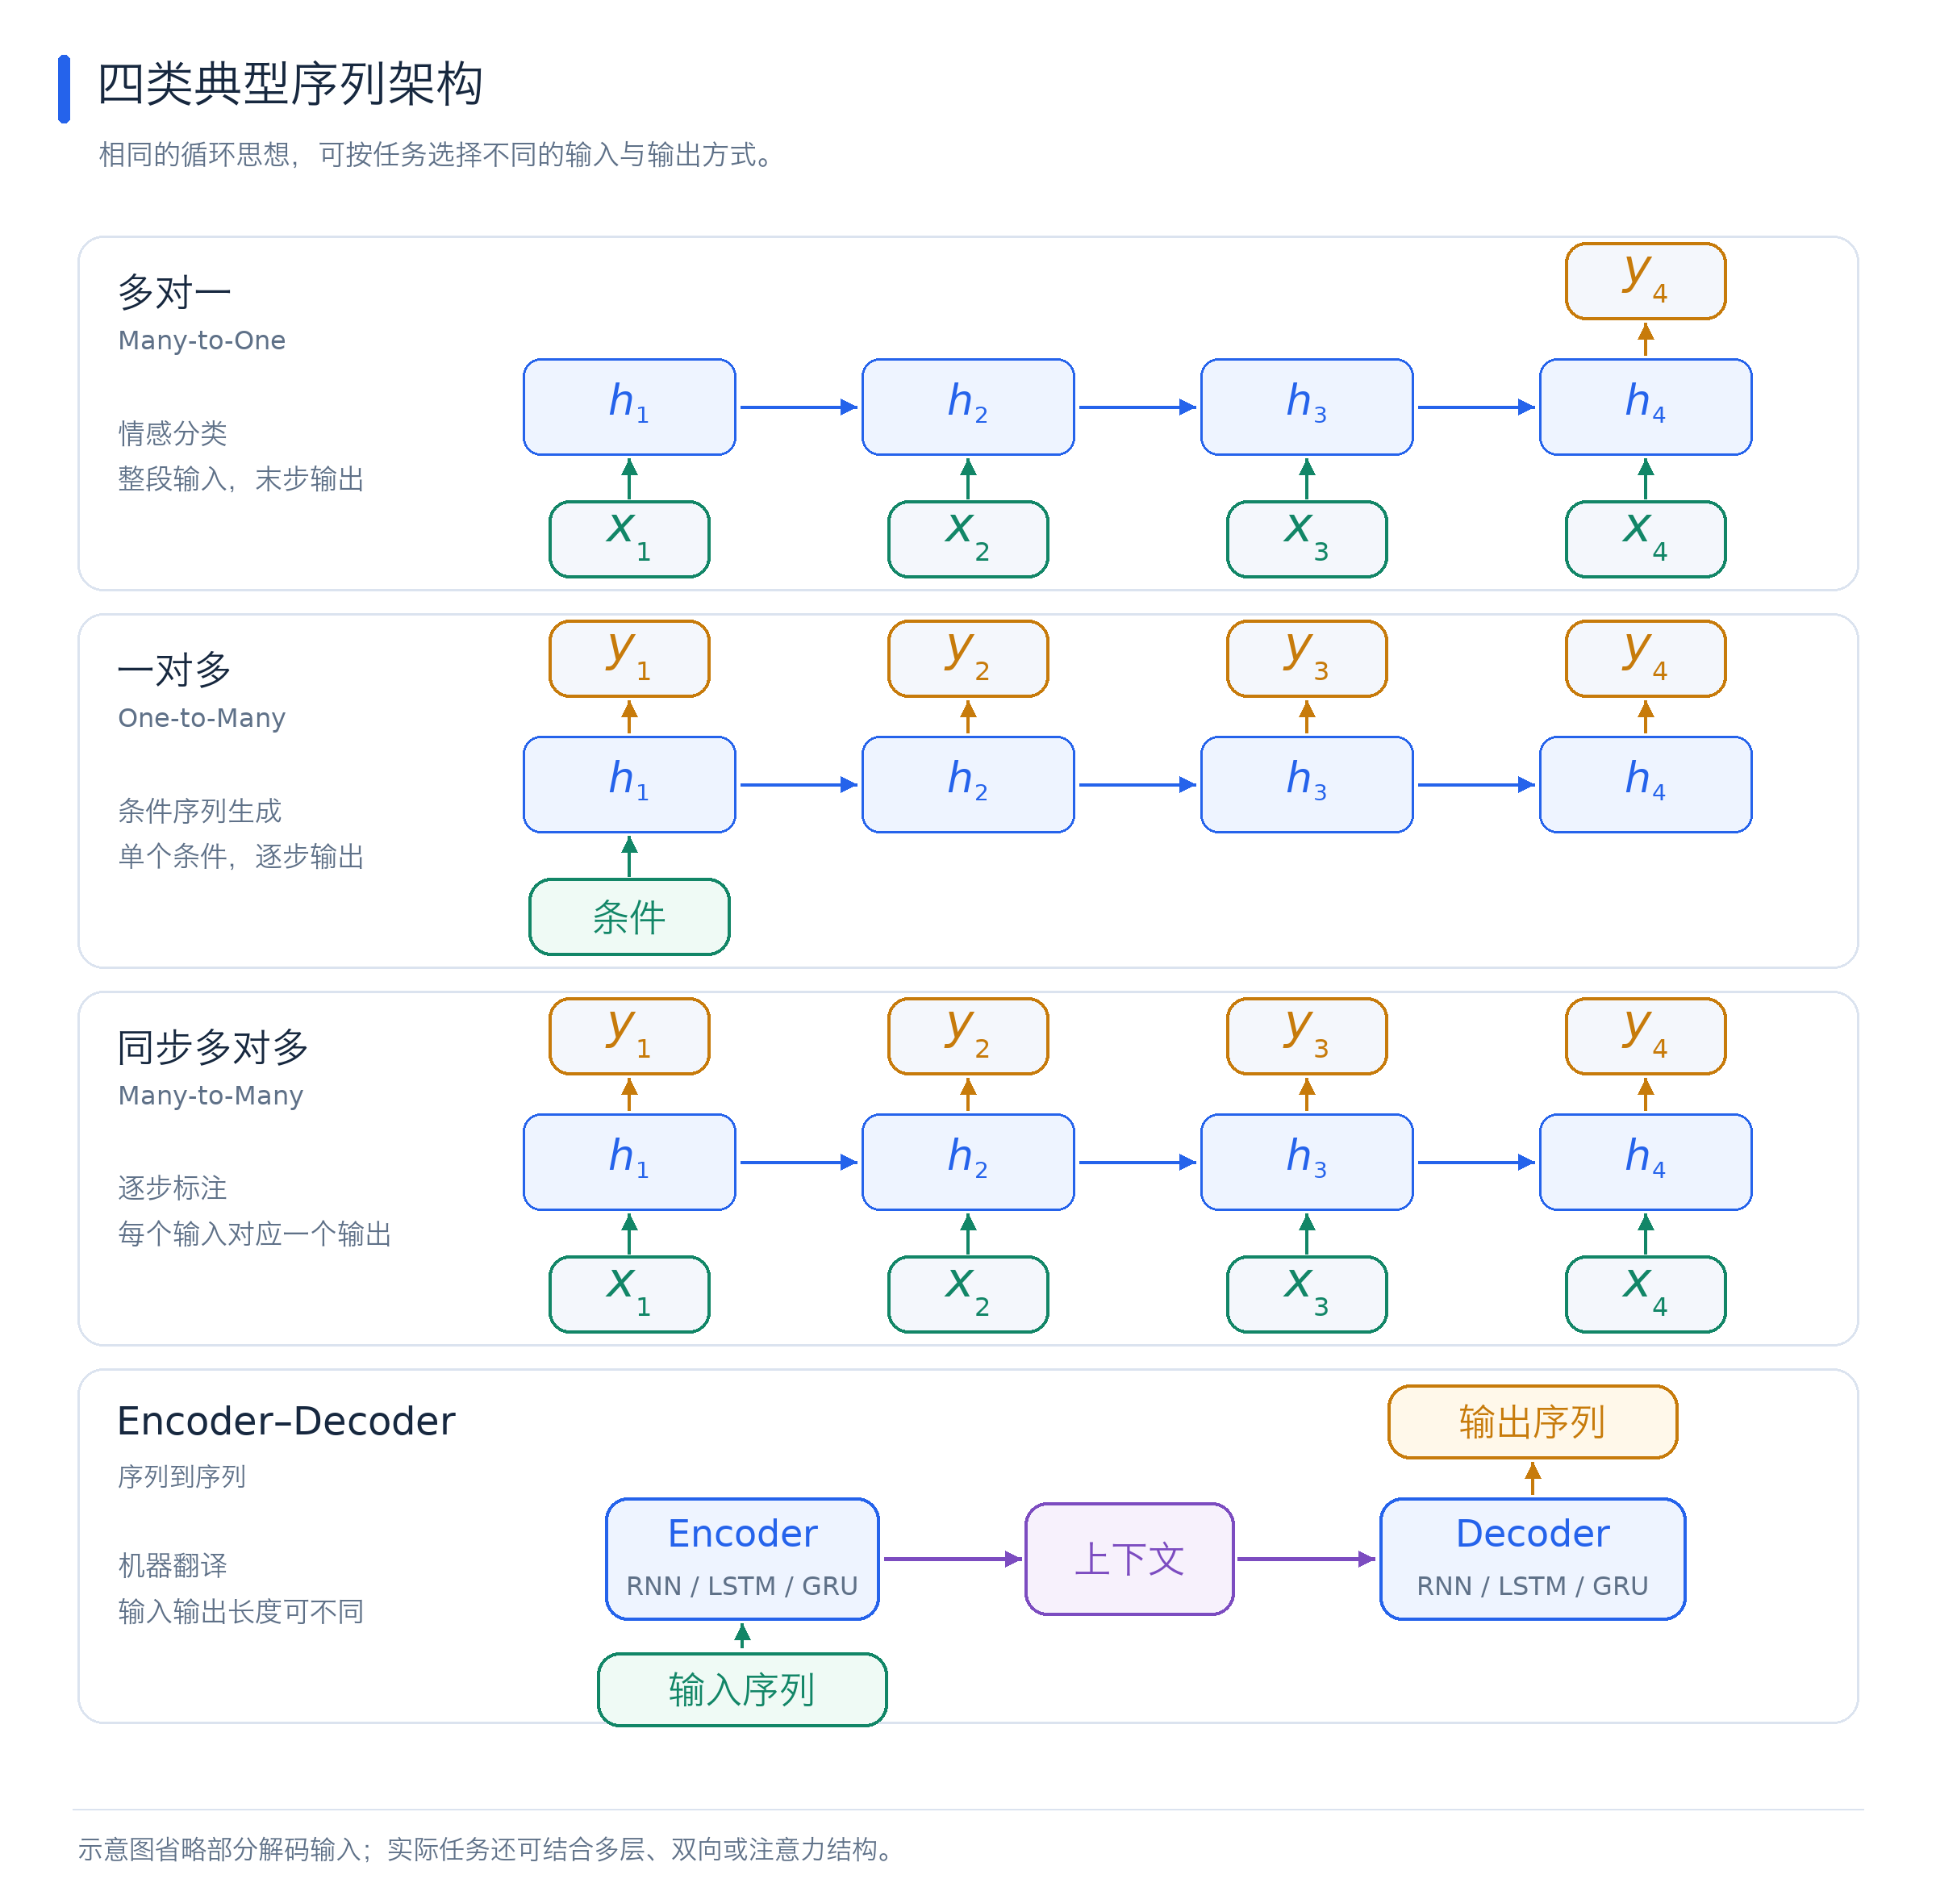
图中展示四类序列架构的信息流,省略部分内部计算细节。
在实际任务中:
- 多对一:文本情感分类、动作识别、整段时间序列分类。
- 多对多同步:词性标注、每帧状态识别、传感器序列异常检测。
- Encoder-Decoder:机器翻译、文本摘要、多步预测。
8.2 双向 RNN(Bidirectional RNN)
普通 RNN 在时间 t 时,通常只能使用当前及过去的信息。
但是,在很多任务中,我们希望同时参考前面的内容和后面的内容。
例如:
我坐在苹果树下,吃了一个苹果。
理解某个词的含义时,前后文都可能提供帮助。
双向 RNN 使用两套循环网络:
正向:
ht=f(Wfxt+Ufht−1+bf)(90)
反向:
ht=f(Wbxt+Ubht+1+bb)(91)
最后拼接:
ht=[ht;ht](92)
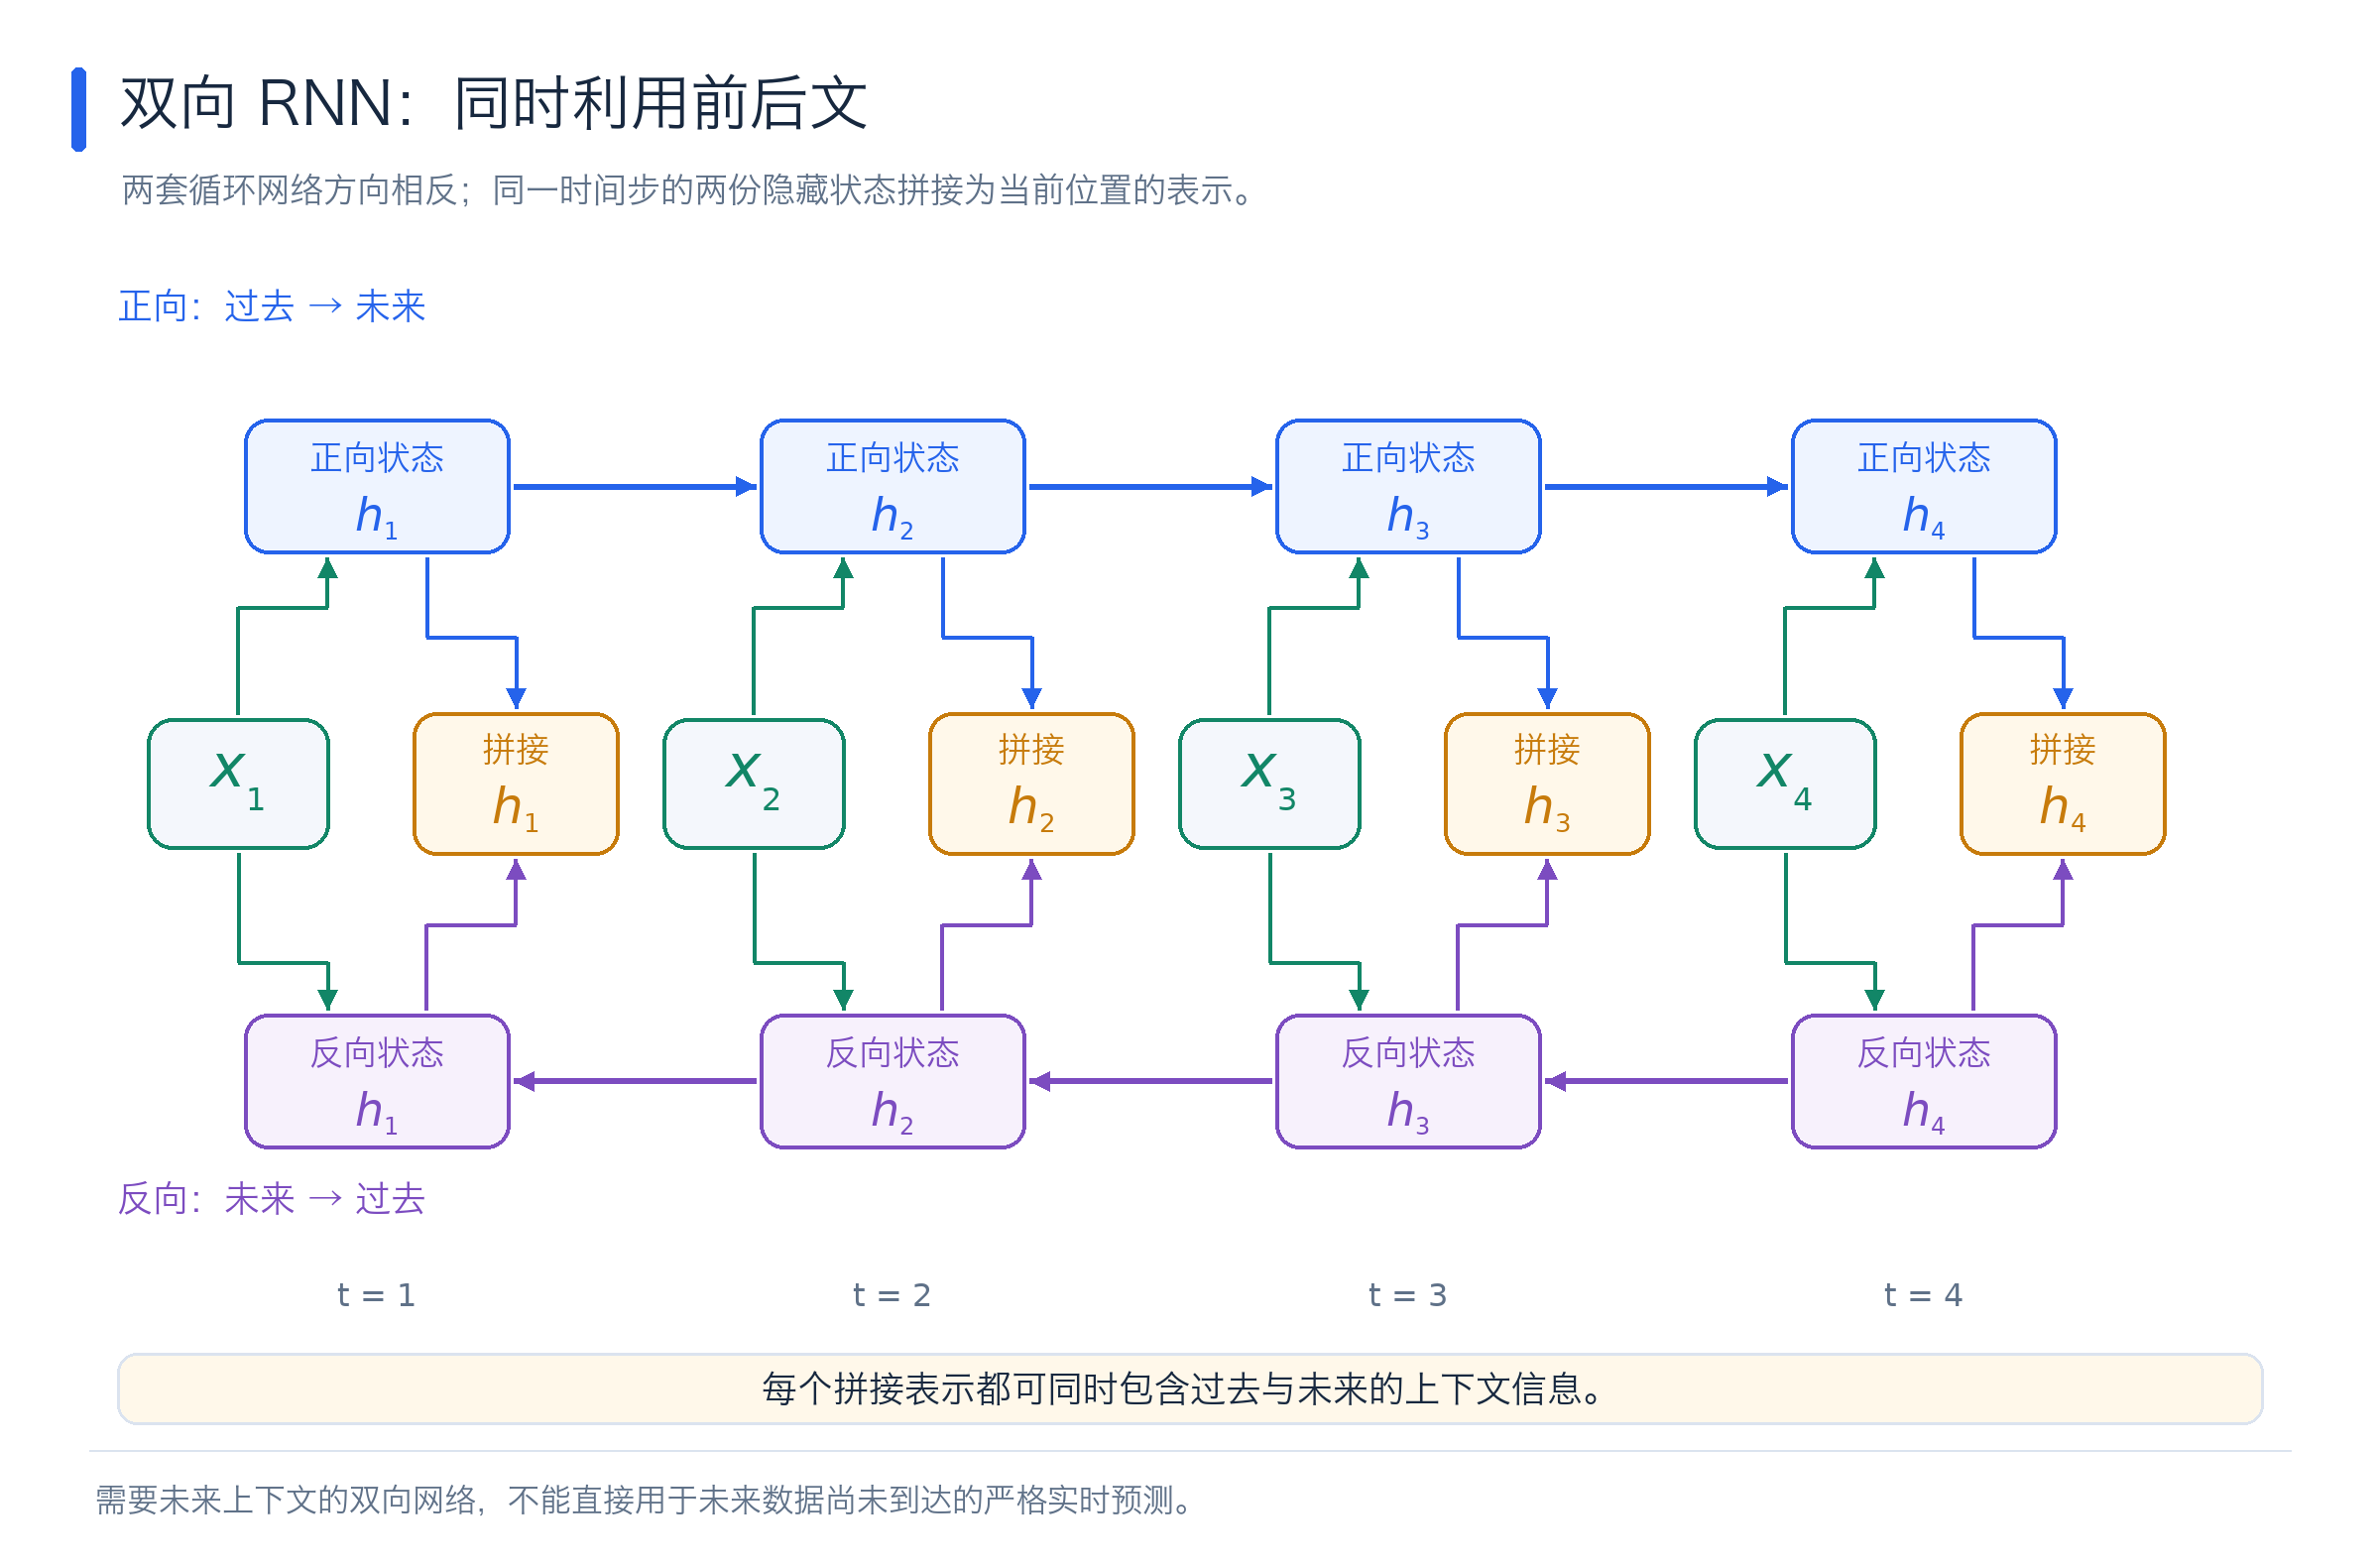
每个时间步将对应的正向和反向隐藏状态拼接,形成该位置的双向表示。
双向结构也可以应用到 LSTM、GRU,因此存在 BiLSTM、BiGRU。
但是存在一个限制:
如果任务要求严格实时预测,而且未来数据尚未到达,那么不能直接使用需要完整未来上下文的双向网络。
例如实时机器人控制或在线时间序列预测,需要特别注意这一点。
8.3 多层 RNN(Stacked RNN)
除了在时间维度展开,也可以在深度方向堆叠。
第一层:
ht(1)=f(Wx(1)xt+Wh(1)ht−1(1)+b(1))
第二层:
ht(2)=f(Wx(2)ht(1)+Wh(2)ht−1(2)+b(2))
推广:
ht(l)=f(Wx(l)ht(l−1)+Wh(l)ht−1(l)+b(l))(93)
其中 l 表示层编号,并约定 ht(0)=xt。可以把它理解为两个信息传播方向:一是随着时间从前往后传递,二是在同一时间步从低层向高层传递。
多层 RNN 可以学习不同抽象层次的时序特征,但也增加了计算量与训练难度。
九、推荐阅读的经典论文
建议按照技术发展的顺序阅读,不必一开始就完整推导每篇论文的全部细节。
Finding Structure in Time — 1990
Jeffrey L. Elman
理解简单循环网络如何通过内部状态建立上下文相关的表示,是学习早期 RNN 的重要文献。
Long Short-Term Memory — 1997
Sepp Hochreiter、Jürgen Schmidhuber
重点研究长期依赖问题,以及通过特殊记忆结构与门控实现较稳定误差传播的思路。注意原始 LSTM 与今天教材中常见的带遗忘门版本并不完全相同。
Learning Phrase Representations using RNN Encoder–Decoder — 2014
Kyunghyun Cho 等人
了解门控循环单元、编码器—解码器及其在机器翻译中的应用。
Neural Machine Translation by Jointly Learning to Align and Translate — 2014/2015
Dzmitry Bahdanau 等人
理解注意力机制为什么能够改善传统 Encoder-Decoder 的固定上下文瓶颈。
Attention Is All You Need — 2017
Ashish Vaswani 等人
理解 Transformer 如何通过自注意力替代传统循环结构中的主要序列交互方式。
Mamba: Linear-Time Sequence Modeling with Selective State Spaces — 2023
Albert Gu、Tri Dao
了解选择性状态空间模型如何融合状态递推与高效序列计算。